Grundlegende Konzepte der Web Audio API
Dieser Artikel erläutert einige Grundlagen der Audiotechnik, die erklären, wie die Funktionen der Web Audio API arbeiten. So können Sie fundierte Entscheidungen treffen, wenn Sie festlegen, wie Ihre App Audiosignale weiterleitet. Wenn Sie noch keine Erfahrung in der Tontechnik haben, erhalten Sie hier genügend Hintergrundwissen, um zu verstehen, warum die Web Audio API so funktioniert, wie sie funktioniert.
Audiographen
Ein Audiograph (oder Audio-Routing-Graph) ist ein Netzwerk verbundener Audio-Nodes innerhalb eines AudioContext. Die Web Audio API verwendet dieses Netzwerk, um Klang zu verarbeiten und zu erzeugen. Jeder Node erfüllt eine bestimmte Aufgabe. Mehrere Nodes werden miteinander verbunden, um einen Signalpfad von einer Quelle zu einem Ziel aufzubauen – in der Regel zu den Lautsprechern. Dieser modulare Aufbau ermöglicht komplexe Audiofunktionen mit dynamischen Effekten.
Mehrere Quellen mit unterschiedlichen Kanalanordnungen werden unterstützt, auch innerhalb eines einzigen Kontexts.
Audio-Nodes werden über ihre Ein- und Ausgänge verbunden. So entsteht eine Kette, die bei einer oder mehreren Quellen beginnt, durch einen oder mehrere Nodes führt und an einem Ziel endet. Wenn Sie Audiodaten lediglich visualisieren möchten, müssen Sie allerdings kein Ziel angeben. Ein einfacher, typischer Ablauf für Web Audio sieht etwa so aus:
- Erstellen Sie den Audiokontext.
- Erstellen Sie Audioquellen innerhalb des Kontexts, beispielsweise
<audio>, einen Oszillator oder einen Stream. - Erstellen Sie Audioeffekte, beispielsweise Reverb-, Biquad-Filter-, Panner- oder Kompressor-Nodes.
- Wählen Sie das endgültige Ziel für das Audiosignal, beispielsweise die Lautsprecher des Computers.
- Verbinden Sie die Quell-Nodes mit keinem, einem oder mehreren Effekt-Nodes und anschließend mit dem gewählten Ziel.
Hinweis: Die Kanalnotation ist eine Zahlenangabe wie 2.0 oder 5.1, die die Anzahl der für ein Signal verfügbaren Audiokanäle angibt. Die erste Zahl bezeichnet die Anzahl der Kanäle mit vollem Frequenzbereich. Die Zahl nach dem Punkt gibt an, wie viele Kanäle für Ausgänge mit Tieffrequenzeffekten (LFE) vorgesehen sind; diese werden oft als Subwoofer bezeichnet.

Jeder Ein- oder Ausgang besteht aus einem oder mehreren Audio-Kanälen, die zusammen eine bestimmte Kanalanordnung bilden. Beliebige diskrete Kanalstrukturen werden unterstützt, darunter Mono, Stereo, Quad, 5.1 und weitere.

Sie haben mehrere Möglichkeiten, Audiosignale zu beziehen:
- Klang kann direkt in JavaScript von einem Audio-Node erzeugt werden, beispielsweise einem Oszillator.
- Er kann aus rohen PCM-Daten erstellt werden, beispielsweise aus .WAV-Dateien oder anderen von
decodeAudioData()unterstützten Formaten. - Er kann von HTML-Medienelementen wie
<video>oder<audio>stammen. - Er kann aus einem WebRTC-
MediaStreamstammen, beispielsweise von einer Webcam oder einem Mikrofon.
Audiodaten: Was steckt in einem Sample?
Bei der Verarbeitung eines Audiosignals findet eine Abtastung statt. Abtastung bezeichnet die Umwandlung eines kontinuierlichen Signals in ein diskretes Signal. Anders ausgedrückt: Eine kontinuierliche Schallwelle, etwa die Musik einer live spielenden Band, wird in eine Folge digitaler Samples (ein zeitdiskretes Signal) umgewandelt. Dadurch kann ein Computer das Audiosignal in einzelnen Blöcken verarbeiten.
Weitere Informationen finden Sie auf der Wikipedia-Seite Sampling (signal processing).
Audiopuffer: Frames, Samples und Kanäle
Ein AudioBuffer wird durch drei Parameter definiert:
- die Anzahl der Kanäle (1 für Mono, 2 für Stereo, sechs für 5.1 usw.),
- seine Länge, also die Anzahl der Sample-Frames im Puffer,
- und die Abtastrate, also die Anzahl der pro Sekunde abgespielten Sample-Frames.
Einige wichtige Begriffe:
- Ein Sample ist ein einzelner 32-Bit-Gleitkommawert, der den Wert des Audiosignals zu einem bestimmten Zeitpunkt in einem bestimmten Kanal darstellt (bei Stereo im linken oder rechten Kanal).
- Ein Frame oder Sample-Frame ist die Gesamtheit der Werte aller Kanäle, die zu einem bestimmten Zeitpunkt abgespielt werden (einer bei Mono, zwei bei Stereo usw.).
- Die Abtastrate gibt an, wie viele dieser Samples (oder Frames, da alle Samples eines Frames gleichzeitig abgespielt werden) pro Sekunde abgespielt werden. Sie wird in Hz gemessen. Je höher die Abtastrate, desto besser die Klangqualität.
Betrachten wir je einen Mono- und einen Stereo-Audiopuffer mit einer Dauer von einer Sekunde bei 44100 Hz:
- Der Mono-Puffer enthält 44.100 Samples und 44.100 Frames. Die Eigenschaft
lengthhat den Wert 44.100. - Der Stereo-Puffer enthält 88.200 Samples, aber weiterhin 44.100 Frames. Die Eigenschaft
lengthhat weiterhin den Wert 44100, da sie der Anzahl der Frames entspricht.

Beim Abspielen eines Puffers hören Sie zuerst den Frame ganz links, dann den unmittelbar daneben, dann den nächsten und so weiter bis zum Ende des Puffers. Bei Stereo hören Sie beide Kanäle gleichzeitig. Sample-Frames sind nützlich, weil sie unabhängig von der Anzahl der Kanäle sind und die Zeit für eine präzise Audiobearbeitung auf ideale Weise abbilden.
Hinweis: Um aus einer Anzahl von Frames eine Zeit in Sekunden zu berechnen, teilen Sie die Anzahl der Frames durch die Abtastrate. Um aus der Anzahl der Samples die Anzahl der Frames zu berechnen, teilen Sie die Anzahl der Samples durch die Anzahl der Kanäle.
Hier sind zwei einfache Beispiele:
const buffer = new AudioBuffer({
  numberOfChannels: 2,
  length: 22050,
  sampleRate: 44100,
});
Hinweis: Bei digitalem Audio sind 44.100 Hz (auch als 44,1 kHz angegeben) eine gängige Abtastfrequenz. Warum 44,1 kHz?
Erstens liegt der Hörbereich des Menschen ungefähr zwischen 20 Hz und 20.000 Hz. Nach dem Nyquist-Shannon-Abtasttheorem muss die Abtastfrequenz mehr als doppelt so hoch sein wie die höchste Frequenz, die wiedergegeben werden soll. Die Abtastrate muss daher höher als 40.000 Hz sein.
Zweitens müssen Signale vor dem Abtasten mit einem Tiefpassfilter gefiltert werden, da sonst Aliasing auftritt. Ein idealer Tiefpassfilter würde Frequenzen unter 20 kHz ohne Dämpfung vollständig durchlassen und Frequenzen über 20 kHz vollständig unterdrücken. In der Praxis ist jedoch ein Übergangsbereich erforderlich, in dem Frequenzen teilweise gedämpft werden. Je breiter dieser Übergangsbereich ist, desto einfacher und kostengünstiger lässt sich ein Anti-Aliasing-Filter herstellen. Die Abtastfrequenz von 44,1 kHz ermöglicht einen Übergangsbereich von 2,05 kHz.
Mit dem obigen Aufruf erhalten Sie einen Stereo-Puffer mit zwei Kanälen. Wird er über einen AudioContext mit 44100 Hz abgespielt (ein sehr gängiger Wert, den die meisten gewöhnlichen Soundkarten verwenden), dauert die Wiedergabe 0,5 Sekunden: 22.050 Frames / 44.100 Hz = 0,5 Sekunden.
const buffer = new AudioBuffer({
  numberOfChannels: 1,
  length: 22050,
  sampleRate: 22050,
});
Mit diesem Aufruf erhalten Sie einen Mono-Puffer (einen Puffer mit einem Kanal). Wird er über einen AudioContext mit 44.100 Hz abgespielt, wird er automatisch auf 44.100 Hz neu abgetastet (und enthält dadurch 44.100 Frames). Die Wiedergabe dauert 1,0 Sekunden: 44.100 Frames / 44.100 Hz = 1 Sekunde.
Hinweis: Die erneute Abtastung von Audiodaten ähnelt stark der Größenänderung eines Bildes. Angenommen, Sie haben ein Bild mit 16 × 16 Pixeln, möchten damit aber eine Fläche von 32 × 32 Pixeln füllen. Dazu ändern Sie seine Größe (oder tasten es neu ab). Das Ergebnis hat eine geringere Qualität: Je nach Verfahren kann es unscharf wirken oder sichtbare Kanten aufweisen. Es funktioniert aber, und das skalierte Bild benötigt weniger Speicherplatz. Bei neu abgetasteten Audiodaten ist es ähnlich: Sie sparen Speicherplatz, können in der Praxis aber hohe Frequenzen oder Höhen nicht originalgetreu wiedergeben.
Planare und verschachtelte Puffer
Die Web Audio API verwendet ein planares Pufferformat. Der linke und der rechte Kanal werden folgendermaßen gespeichert:
LLLLLLLLLLLLLLLLRRRRRRRRRRRRRRRR (for a buffer of 16 frames)
Diese Struktur ist in der Audioverarbeitung weit verbreitet und erleichtert die unabhängige Verarbeitung jedes Kanals.
Eine Alternative ist ein verschachteltes Pufferformat:
LRLRLRLRLRLRLRLRLRLRLRLRLRLRLRLR (for a buffer of 16 frames)
Dieses Format wird häufig verwendet, um Audiodaten ohne aufwendige Verarbeitung zu speichern und abzuspielen, beispielsweise bei .WAV-Dateien oder einem dekodierten MP3-Stream.
Da die Web Audio API für die Verarbeitung konzipiert ist, stellt sie ausschließlich planare Puffer bereit. Sie verwendet das planare Format, wandelt die Audiodaten aber in das verschachtelte Format um, wenn sie sie zur Wiedergabe an die Soundkarte sendet. Umgekehrt beginnt die API beim Dekodieren einer MP3-Datei mit dem verschachtelten Format und wandelt es zur Verarbeitung in das planare Format um.
Audiokanäle
Audiopuffer können unterschiedlich viele Kanäle enthalten. Die meisten modernen Audiogeräte verwenden die grundlegenden Einstellungen Mono (nur ein Kanal) und Stereo (linker und rechter Kanal). Einige komplexere Systeme unterstützen Surround-Sound-Anordnungen wie Quad und 5.1. Dank der größeren Anzahl an Kanälen können sie ein räumlicheres Klangerlebnis bieten. Für die Kanäle verwenden wir üblicherweise die Standardabkürzungen aus der folgenden Tabelle:
| Name | Kanäle |
|---|---|
| Mono | 0: M: mono |
| Stereo | 0: L: left 1: R: right |
| Quad | 0: L: left 1: R: right 2: SL: surround left 3: SR: surround right |
| 5.1 | 0: L: left 1: R: right 2: C: center 3: LFE: subwoofer 4: SL: surround left 5: SR: surround right |
Up-Mixing und Down-Mixing
Wenn die Anzahl der Eingangs- und Ausgangskanäle nicht übereinstimmt, ist Up-Mixing oder Down-Mixing erforderlich. Die folgenden Regeln gelten abhängig davon, ob die Eigenschaft AudioNode.channelInterpretation auf speakers oder discrete gesetzt ist:
| Interpretation | Eingangskanäle | Ausgangskanäle | Mischregeln |
|---|---|---|---|
speakers |
1 (Mono) |
2 (Stereo) |
Up-Mix von Mono auf Stereo. Der Eingangskanal M
wird für beide Ausgangskanäle (L und
R) verwendet.output.L = input.M
|
1 (Mono) |
4 (Quad) |
Up-Mix von Mono auf Quad. Der Eingangskanal M
wird für die vorderen Ausgangskanäle (L und
R) verwendet. Die Surround-Ausgangskanäle (SL und
SR) bleiben stumm.output.L = input.M
|
|
1 (Mono) |
6 (5.1) |
Up-Mix von Mono auf 5.1. Der Eingangskanal M
wird für den mittleren Ausgangskanal (C) verwendet. Alle anderen
(L, R, LFE, SL und
SR) bleiben stumm.output.L = 0output.C = input.M
|
|
2 (Stereo) |
1 (Mono) |
Down-Mix von Stereo auf Mono. Die beiden Eingangskanäle ( L
und R) werden zu gleichen Teilen zum einzigen Ausgangskanal
(M) kombiniert.output.M = 0.5 * (input.L + input.R)
|
|
2 (Stereo) |
4 (Quad) |
Up-Mix von Stereo auf Quad. Die Eingangskanäle L
und R werden für die entsprechenden vorderen Ausgangskanäle
(L und R) verwendet. Die Surround-Ausgangskanäle
(SL und SR) bleiben stumm.output.L = input.L
|
|
2 (Stereo) |
6 (5.1) |
Up-Mix von Stereo auf 5.1. Die Eingangskanäle L
und R werden für die entsprechenden vorderen Ausgangskanäle
(L und R) verwendet. Die Surround-Ausgangskanäle
(SL und SR) sowie der mittlere Kanal
(C) und der Subwoofer-Kanal (LFE) bleiben
stumm.output.L = input.L
|
|
4 (Quad) |
1 (Mono) |
Down-Mix von Quad auf Mono. Alle vier Eingangskanäle ( L, R, SL und SR)
werden zu gleichen Teilen zum einzigen Ausgangskanal
(M) kombiniert.output.M = 0.25 * (input.L + input.R + input.SL + input.SR)
|
|
4 (Quad) |
2 (Stereo) |
Down-Mix von Quad auf Stereo. Die beiden linken Eingangskanäle ( L und SL) werden zu gleichen Teilen zum
linken Ausgangskanal (L) kombiniert. Entsprechend werden
die beiden rechten Eingangskanäle (R und SR)
zu gleichen Teilen zum rechten Ausgangskanal (R)
kombiniert.output.L = 0.5 * (input.L + input.SL)output.R = 0.5 * (input.R + input.SR)
|
|
4 (Quad) |
6 (5.1) |
Up-Mix von Quad auf 5.1. Die Eingangskanäle L,
R, SL und SR werden für ihre
jeweiligen Ausgangskanäle (L, R,
SL und SR) verwendet. Der mittlere Kanal
(C) und der Subwoofer-Kanal (LFE) bleiben
stumm.output.L = input.Loutput.R = input.Routput.C = 0output.LFE = 0output.SL = input.SLoutput.SR = input.SR
|
|
6 (5.1) |
1 (Mono) |
Down-Mix von 5.1 auf Mono. Die linken Kanäle ( L
und SL), die rechten Kanäle (R und
SR) sowie der mittlere Kanal werden zusammengemischt. Die
Surround-Kanäle werden etwas gedämpft; die vorderen Seitenkanäle
werden durch Multiplikation mit √2/2 hinsichtlich ihrer
Leistung angepasst, damit sie zusammen wie ein einzelner Kanal
berücksichtigt werden. Der Subwoofer-Kanal (LFE) entfällt.output.M = 0.7071 * (input.L + input.R) + input.C + 0.5 * (input.SL + input.SR)
|
|
6 (5.1) |
2 (Stereo) |
Down-Mix von 5.1 auf Stereo. Der mittlere Kanal ( C) wird jeweils mit einem seitlichen Surround-Kanal (SL
oder SR) summiert und dem entsprechenden Seitenkanal
beigemischt. Da auf zwei Kanäle heruntergemischt wird, erfolgt die
Beimischung mit geringerer Leistung: Der jeweilige Anteil wird mit
√2/2 multipliziert. Der Subwoofer-Kanal
(LFE) entfällt.output.L = input.L + 0.7071 * (input.C + input.SL)output.R = input.R + 0.7071 * (input.C + input.SR)
|
|
6 (5.1) |
4 (Quad) |
Down-Mix von 5.1 auf Quad. Der mittlere Kanal ( C) wird den vorderen Seitenkanälen (L und
R) beigemischt. Da er auf zwei Kanäle verteilt wird,
erfolgt die Beimischung mit geringerer Leistung: Der jeweilige Anteil
wird mit √2/2 multipliziert. Die Surround-Kanäle werden
unverändert übernommen. Der Subwoofer-Kanal (LFE)
entfällt.output.L = input.L + 0.7071 * input.Coutput.R = input.R + 0.7071 * input.Coutput.SL = input.SLoutput.SR = input.SR
|
|
| Andere, nicht standardmäßige Kanalanordnungen |
Nicht standardmäßige Kanalanordnungen verhalten sich so, als wäre
channelInterpretation auf
discrete gesetzt.Die Spezifikation lässt ausdrücklich zu, dass künftig neue Lautsprecheranordnungen definiert werden. Dieser Fallback ist daher nicht zukunftssicher: Das Verhalten der Browser bei einer bestimmten Kanalanzahl kann sich künftig ändern. |
||
discrete |
beliebig (x) |
beliebig (y), wobei x<y |
Up-Mix diskreter Kanäle. Jeder Ausgangskanal wird mit seinem entsprechenden Eingangskanal belegt — also mit dem Eingangskanal mit demselben Index. Kanäle ohne entsprechenden Eingangskanal bleiben stumm. |
beliebig (x) |
beliebig (y), wobei x>y |
Down-Mix diskreter Kanäle. Jeder Ausgangskanal wird mit seinem entsprechenden Eingangskanal belegt — also mit dem Eingangskanal mit demselben Index. Eingangskanäle ohne entsprechenden Ausgangskanal werden verworfen. |
|
Visualisierungen
Für Audiovisualisierungen erfassen wir in der Regel das Ausgangssignal im zeitlichen Verlauf und lesen dabei beispielsweise Pegel- oder Frequenzdaten aus. Anschließend wandeln wir die gewonnenen Daten mit einem Grafikwerkzeug in eine visuelle Darstellung um, etwa ein Diagramm. Die Web Audio API stellt dafür einen AnalyserNode bereit. Er verändert das Audiosignal, das ihn durchläuft, nicht und gibt zusätzlich Audiodaten aus, die wir beispielsweise mit <canvas> verarbeiten können.
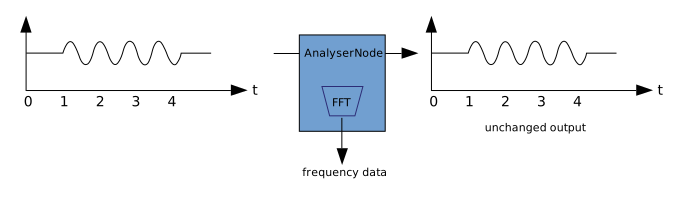
Mit den folgenden Methoden können Sie Daten abrufen:
AnalyserNode.getFloatFrequencyData()-
Kopiert die aktuellen Frequenzdaten in ein übergebenes
Float32Array-Array. AnalyserNode.getByteFrequencyData()-
Kopiert die aktuellen Frequenzdaten in ein übergebenes
Uint8Array(ein Array vorzeichenloser Bytes). AnalyserNode.getFloatTimeDomainData()-
Kopiert die aktuellen Wellenform- beziehungsweise Zeitbereichsdaten in ein übergebenes
Float32Array-Array. AnalyserNode.getByteTimeDomainData()-
Kopiert die aktuellen Wellenform- beziehungsweise Zeitbereichsdaten in ein übergebenes
Uint8Array(ein Array vorzeichenloser Bytes).
Hinweis: Weitere Informationen finden Sie in unserem Artikel Visualisierungen mit der Web Audio API.
Räumliche Audiowiedergabe
Mit räumlicher Audiowiedergabe können wir die Position und das Verhalten eines Audiosignals an einem bestimmten Punkt im Raum modellieren und simulieren, wie eine hörende Person dieses Signal wahrnimmt. In der Web Audio API übernehmen PannerNode und AudioListener die räumliche Audiowiedergabe.
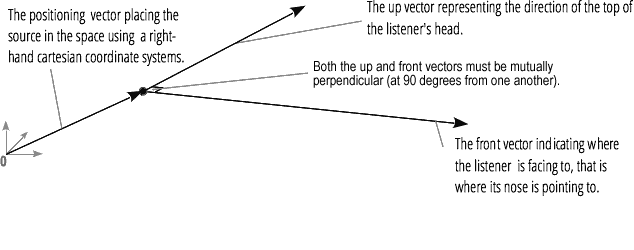
Der Panner verwendet ein rechtshändiges kartesisches Koordinatensystem. Er beschreibt die Position der Audioquelle als Vektor und ihre Ausrichtung als dreidimensionalen Richtungskegel. Dieser Kegel kann beispielsweise bei omnidirektionalen Quellen sehr groß sein.

Auch die hörende Person wird in der Web Audio API mithilfe eines rechtshändigen kartesischen Koordinatensystems beschrieben: ihre Position durch einen Vektor und ihre Ausrichtung durch zwei Richtungsvektoren, up und front. Diese Vektoren geben an, in welche Richtung der Scheitel beziehungsweise die Nase der Person zeigt. Sie stehen senkrecht zueinander.
Hinweis: Weitere Informationen finden Sie in unserem Artikel Grundlagen der räumlichen Audiowiedergabe mit Web Audio.
Fan-in und Fan-out
In der Audiotechnik bezeichnet Fan-in einen Vorgang, bei dem ein ChannelMergerNode mehrere Mono-Eingangsquellen zu einem einzigen Mehrkanalsignal zusammenführt:

Fan-out bezeichnet den umgekehrten Vorgang: Ein ChannelSplitterNode nimmt eine Mehrkanal-Eingangsquelle entgegen und gibt mehrere Mono-Ausgangssignale aus:
